VLAロボットの安全学習を改善するShieldVLA、現場PoCで見るべき点
3行解説
- VLAモデル向けに、安全性を学習へ組み込む新手法「ShieldVLA」が提案された。
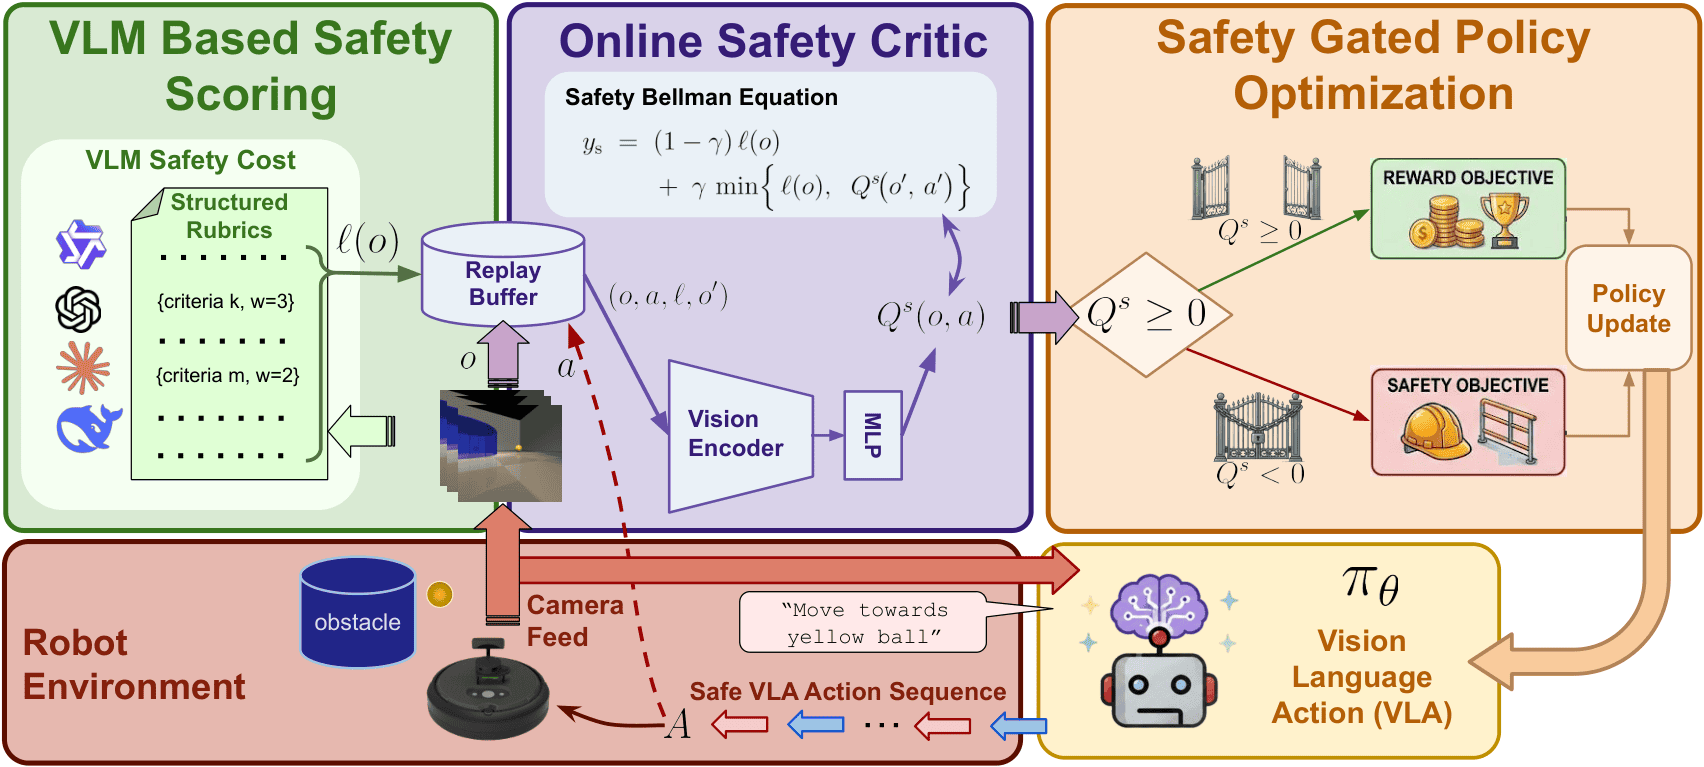
- 視覚観測から安全領域を推定し、危険状態では回復動作に切り替える。
- 5つのベンチマークで安全コストを平均57%下げ、成功率も改善した。
ニュースの概要
arXivのRobotics分野で、2026年9月2日に「ShieldVLA: Feasibility-Aware Safety Alignment for Vision-Language-Action Models」という論文が公開された。著者はManan Tayal氏とAkshay Nambi氏。論文は、ロボットの操作や移動に使うVision-Language-Action(VLA)モデルに対して、安全性を後付けではなく学習段階で整合させる枠組みを提案している。対象は、ナビゲーションとマニピュレーションの複数ベンチマークで、複数のVLAバックボーンにまたがって評価されている。
何が新しいのか
従来の安全学習は、期待累積コストに罰則をかけるLagrangian最適化に頼ることが多く、制約違反が残ったり、逆に保守的になりすぎたりする課題があった。ShieldVLAは、Hamilton-Jacobi(HJ)reachabilityに基づく安全クリティックを学習し、視覚情報から安全に動ける領域を推定する点が新しい。さらに、危険状態の近くでは報酬最大化ではなく回復に切り替えるため、報酬と安全の綱引きを減らす設計になっている。
もう一つの特徴は、密な1ステップごとの安全ラベルを前提にしないことだ。代わりに、rubric-based VLM safety scoresを使い、意味ベースの安全フィードバックを構造化した教師信号に変換する。論文では、5つのベンチマークで平均57%の累積安全コスト削減、SafeVLA比でタスク成功率+0.13を報告している。
GA Roboticsの視点
この論文で重要なのは、「危険を避ける」だけでなく「危険に近づいたときに回復へ切り替える」設計を、視覚ベースで学習している点です。現場導入では、単純な停止よりも、停止後にどう復帰するかが稼働率を左右します。平均57%の安全コスト削減と成功率+0.13という結果は、少なくとも研究段階では、安全強化が性能低下と必ずしもトレードオフではないことを示しています。ただし、これはベンチマーク上の結果であり、実機の速度、荷物形状、人の往来がある環境で同じ傾向が出るかは別問題です。
日本の現場で考えると
日本の製造・物流・サービス現場では、VLA系ロボットを使う際に「安全に止まる」だけでなく、「止まった後に再開できるか」が重要です。通路が狭い倉庫、作業者が頻繁に横切る工程、棚や台車が動く環境では、危険状態の近傍で回復動作へ切り替える考え方が役立つ可能性があります。一方で、段差、反射、混雑、予測しにくい人の動きが多い現場では、視覚だけで安全領域を推定する前提を慎重に確認する必要があります。
また、rubric-based VLM safety scoresは、現場の安全ルールやヒヤリハットの記録を学習データに変換する発想と相性がよい一方、ルールの書き方が曖昧だと評価もぶれます。日本で導入するなら、既存のWMSやMES、PLCと連携する前に、まずは「どの場面を危険とみなすか」を現場と合意しておくことが重要です。
導入・PoCで確認したいこと
- 危険シナリオを再現したときに、安全停止と回復動作が正しく切り替わるか。
- 通常時と危険回避時で、1サイクル時間がどれだけ変わるか。
- 人や障害物が増えたときに、介入回数や誤停止がどの程度増えるか。
- 連続稼働中に、安全コスト低減と成功率向上が現場条件でも維持されるか。
- レイアウト変更後に、安全領域の再設定や再学習にどれだけ時間がかかるか。
現時点で分かっていないこと
論文要約だけでは、実機での検証条件や対象ロボットの種類は確認できない。また、日本の現場で必要になる安全認証、運用手順、責任分界についても記載はない。5つのベンチマークでの改善は示されているが、実環境での再現性は提供情報だけでは判断できない。
VLA系ロボットの導入では、性能だけでなく安全評価の設計が重要です。日本の現場でどうPoCに落とし込むかを整理したい場合は、導入相談の前に論点を明確にしておくと判断しやすくなります。
ロボット導入・自動化をご検討の方へ
「自社にはどんなロボットが合うのか」お悩みではありませんか。貴社の現場課題に合わせた最適な活用方法をご提案します。まずはご相談・資料請求からお気軽にどうぞ。