
VLAとは何か ロボットが指示を理解して動く仕組みを整理
3行解説
- EdgeTech+ 2026に向け、フィジカルAIの基礎用語としてVLAが紹介された。
- VLAは視覚と言語をもとに、ロボットの具体的な動作を生成するAIモデル。
- 従来の細かな手順設定と違い、異なる指示や環境への対応をめざす。
ニュースの概要
ロボスタは2026年10月30日、11月18~20日に神奈川県横浜市のパシフィコ横浜で開かれる「EdgeTech+ 2026」に向けた解説記事を公開した。記事では、フィジカルAIを支えるキーワードとして「VLA」を取り上げ、あわせてワールドモデル、AIエージェント、マルチモーダルAIの関係も整理している。
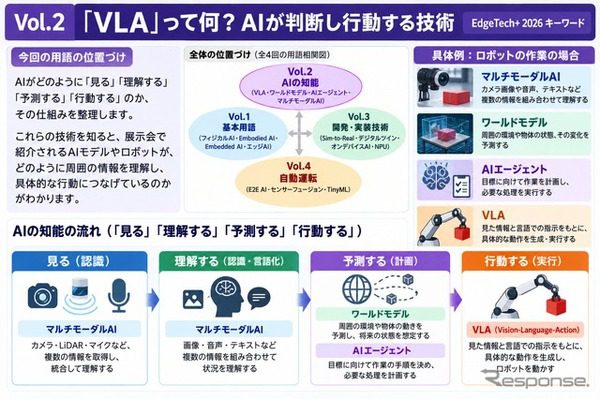
VLAはVision-Language-Actionの略で、視覚情報と言語情報をもとに行動を生成するAIモデルと説明された。例として、ロボットに「机の上にある赤い箱を持ち上げて」と指示した場合、カメラで対象を見つけ、腕や手の動かし方を決める流れが示されている。記事は、従来のロボット制御との違いを理解する入口としてVLAを位置づけている。
何が新しいのか
この記事の新しさは、VLAを単独の流行語としてではなく、フィジカルAIの中で「見る」「理解する」「予測する」「行動する」の流れの一部として整理している点にある。ワールドモデルは環境変化の予測、AIエージェントは目標達成の計画、マルチモーダルAIは複数種類の情報処理を担うと説明し、VLAとの役割分担を明確にしている。
また、従来のロボット制御が作業ごとに動作手順を細かく設定する方式だったのに対し、VLAは学習した知識を使って異なる指示や環境に対応することをめざすと整理している。つまり、現場での関心は「ロボットが賢くなるか」だけでなく、どこまで指示の柔軟性を持たせられるか、例外時にどう扱うかへ移る。EdgeTech+ 2026では、その実装側の技術にも注目すべきだと示している。
GA Robotics編集部注目のポイント
注目したいのは、VLAが「視覚情報と言語情報をもとに、具体的な行動を生成する」と明記されている点です。これは、ロボット導入時に人が細かい動作を教え込むだけでなく、指示の出し方そのものを設計対象にする必要があることを意味します。
一方で、記事はVLAが異なる指示や環境への対応をめざすと述べるにとどまり、どの程度の例外処理や安全確認が必要かまでは示していません。現場導入では、自然言語で任せられる範囲と、従来どおり手順固定が必要な範囲を切り分けることが重要だとみられます。
日本の現場で考えると
日本の製造・物流・サービス現場では、VLAは「指示を受けて動く」作業に向きやすい一方、作業条件が毎回変わる工程では慎重な検証が必要です。たとえば、箱を取る、運ぶ、置くといった単純な動作でも、通路幅や障害物、人とのすれ違いがあると、認識と判断の安定性が重要になります。
逆に、段差が多い場所、対象物の形状や置き方がばらつく場所、誤動作時の影響が大きい工程では、VLAだけに任せるのは早い可能性があります。既存のWMSやMES、PLCとどうつなぐかも論点で、ロボット単体の賢さより、現場の指示系統と安全ルールに合わせて運用できるかが導入可否を左右します。
導入・PoCで確認したいこと
- 指示文に対する作業成功率
- 1回あたりの作業サイクル時間
- 例外発生時の人の介入回数
- 連続稼働時の認識・動作の安定性
- レイアウト変更後の再設定時間
現時点で分かっていないこと
この記事は用語解説が中心で、VLAを使った具体的な製品名、実機デモ、導入事例は示していません。そのため、日本の現場でどの業務まで実用化できるかは、この記事だけでは判断できません。
また、EdgeTech+ 2026でVLA関連のどの企業・製品が出展するか、会場でどの程度の実装レベルが確認できるかも本文では分かりません。VLAとワールドモデル、AIエージェントのどこを実装しているかも、個別発表を待つ必要があります。
VLAの考え方は、ロボットに何を任せられるかを見極めるうえで重要です。現場での適用範囲を考える際は、自然言語での指示と例外処理をどう設計するかが論点になります。
ロボット導入・自動化をご検討の方へ
「自社にはどんなロボットが合うのか」お悩みではありませんか。貴社の現場課題に合わせた最適な活用方法をご提案します。まずはご相談・資料請求からお気軽にどうぞ。
出典: ロボスタ

