
VLA方策の耐性を後付け移植、arXiv論文が示した実機検証の要点
3行解説
- VLA方策の耐性を、別タスクで学んだ防御更新から移植する手法が提案された。
- ターゲット側の敵対的データや追加推論モジュールを使わずに適用できるとしている。
- 実機PiPER試験では、印刷パッチ下の平均成功率が20.3%から45.8%に上がった。
ニュースの概要
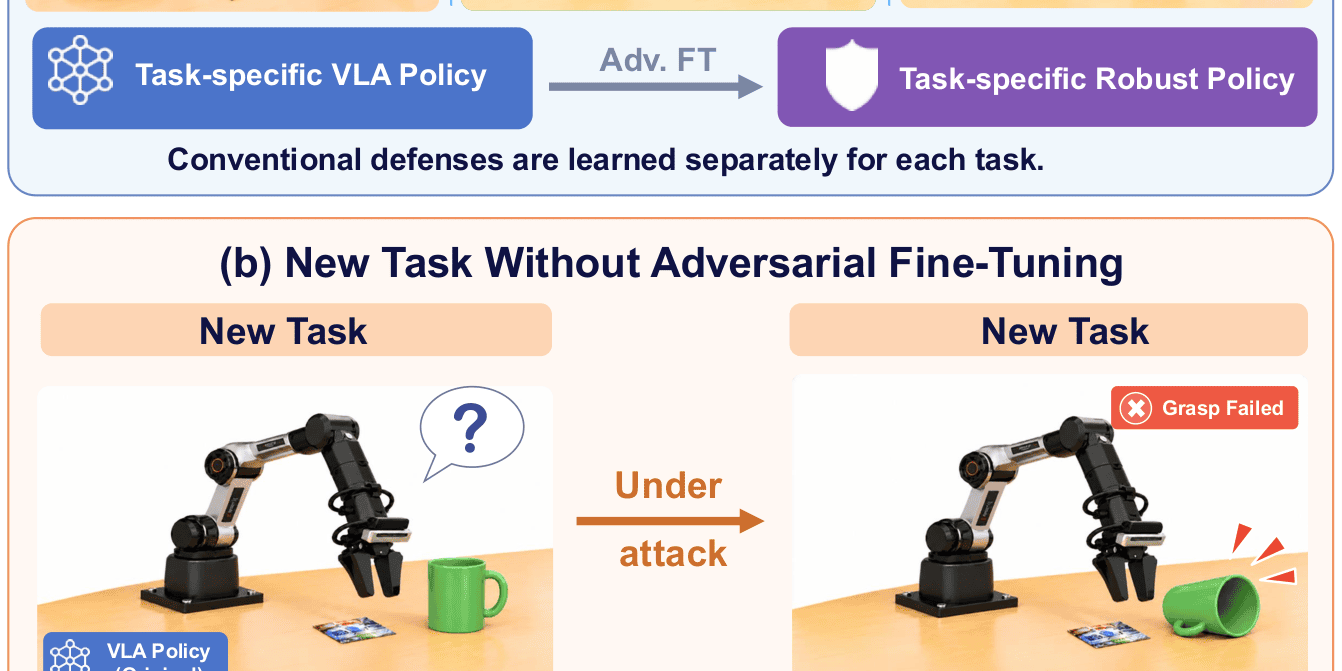
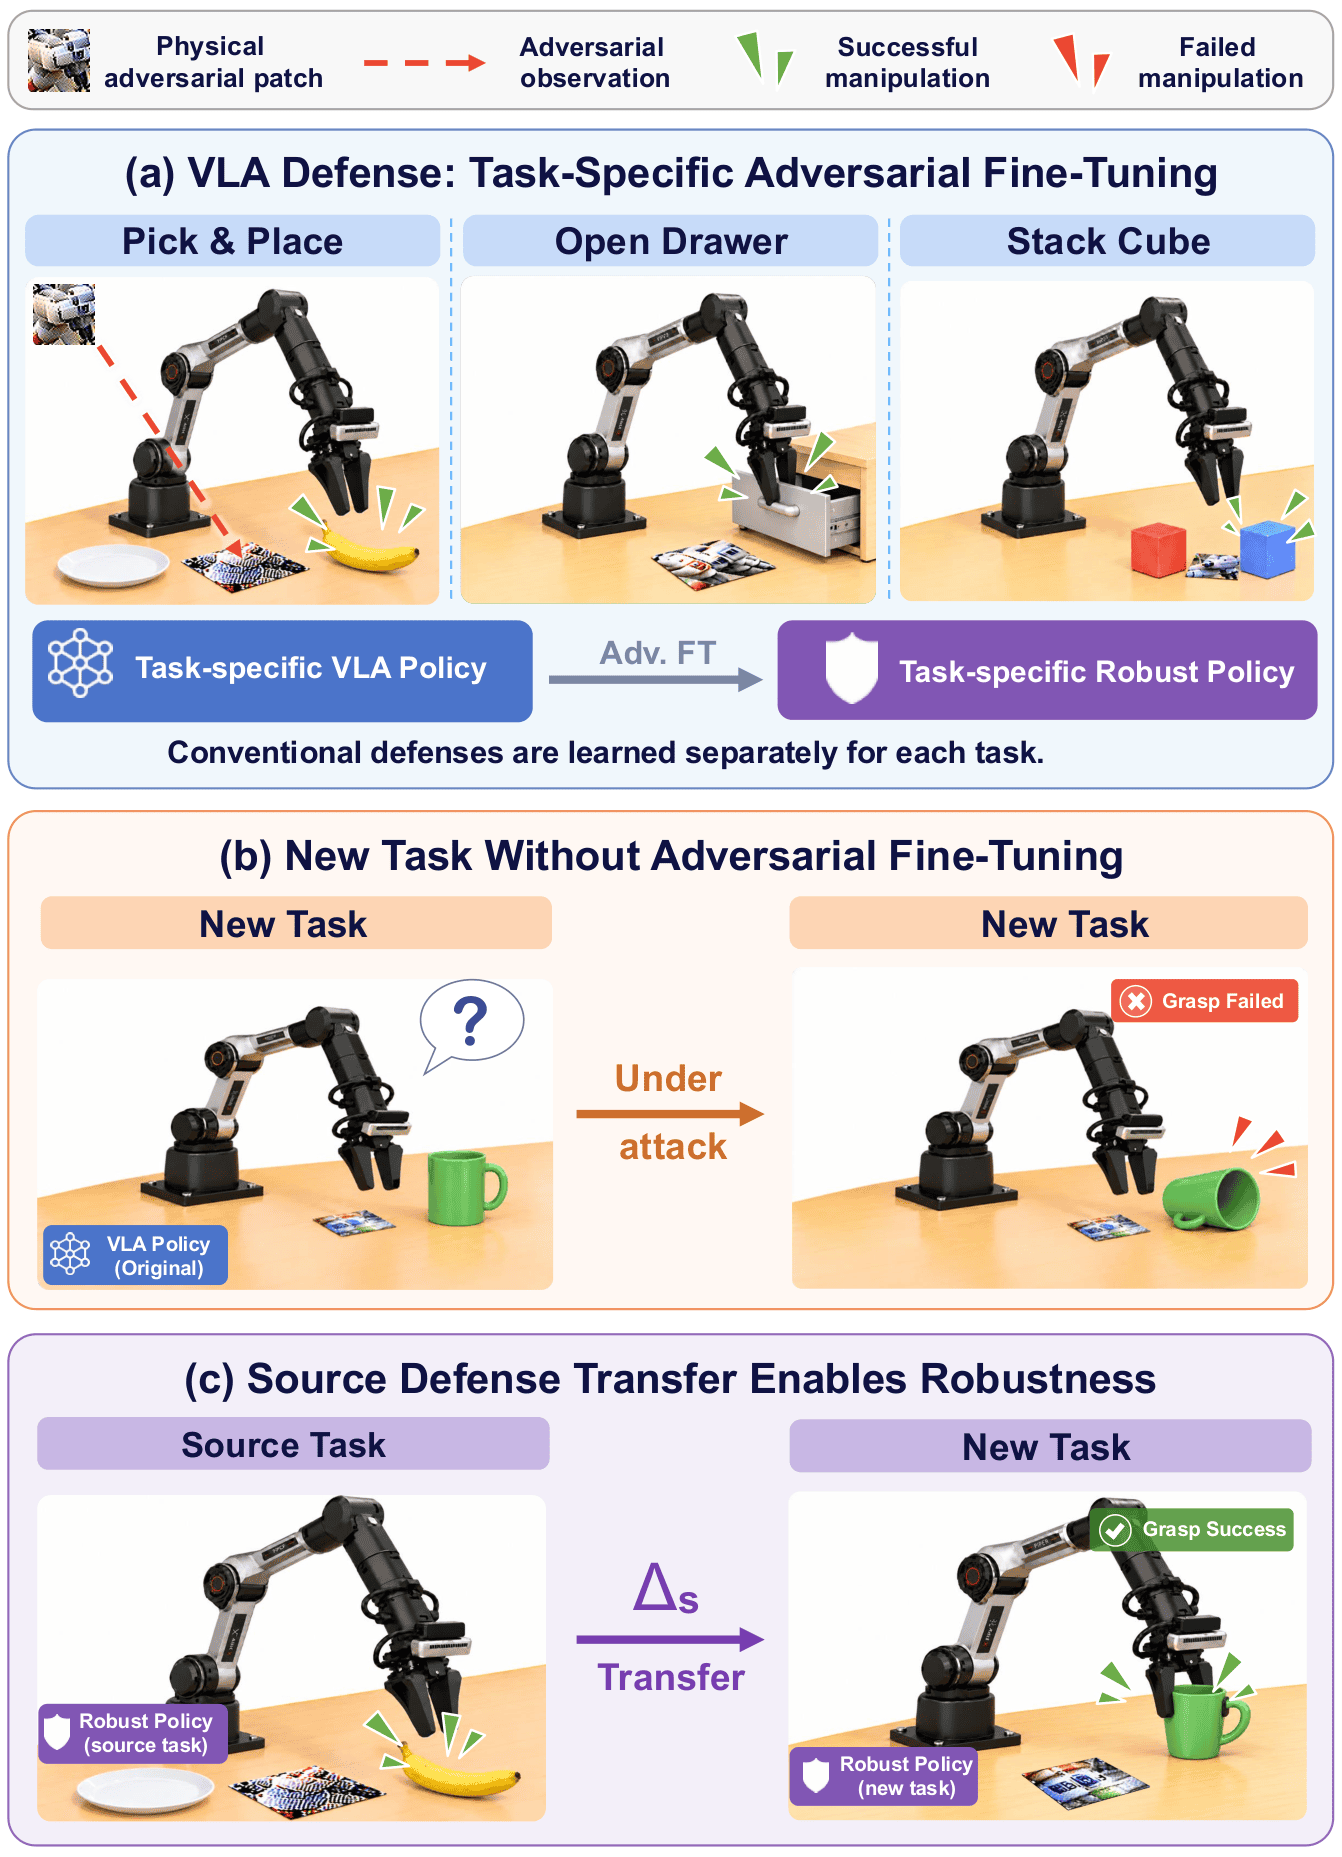
arXivのRobotics分野に、Vision-Language-Action(VLA)方策の耐性を扱う論文が掲載された。タイトルは「Robustness as a Transferable Skill: Cross-Task Adversarial Defense for Vision-Language-Action Policies」で、2026年11月6日に投稿されている。著者らは、視覚的な敵対的摂動に弱いVLA方策に対し、ソース側の操作タスクで学んだ防御を別タスクへ転用できるかを検討した。
論文では、ターゲット側での敵対的学習を行わずに、ソース防御更新をターゲットの視覚エンコーダへ適用する枠組みを示している。さらに、Source-Norm Transferable Robustness Vector(SN-TRV)という更新法を提案し、複数の評価条件で既存の単純平均より良い結果を示したとしている。
何が新しいのか
新しさは、耐性を「そのタスク専用の追加学習」で作るのではなく、別タスクで得た防御更新を再利用する点にある。論文は、単一のソース防御更新でも未学習タスクの耐性が改善すると示し、さらに複数ソースの更新をまとめる際にSN-TRVを使うことで、平均方向を保ちながら大きさを調整する方法を提案した。
また、適用先ではターゲット側の敵対的データ、ターゲット側の勾配最適化、追加の推論モジュールを使わないとしている。評価は3種類のVLAバックボーン、固定攻撃と適応攻撃、異なる防御レシピにまたがって行われ、物理PiPER試験では印刷パッチ下の平均成功率が20.3%から45.8%に改善した。
GA Robotics編集部注目のポイント
注目すべきは、ターゲット側の敵対的データなしで防御を移植できるとする点です。現場導入では、追加学習のために危険な状況を再現したり、推論系を増やしたりする負担が小さくなる可能性があります。一方で、論文自身が「攻撃カバレッジの限界」を示しているため、万能な防御ではなく、どの攻撃に効くかを切り分けて見る必要があります。
さらに、3つのVLAバックボーンと固定・適応攻撃の両方で評価しているため、特定モデルだけの偶然の結果とは言い切りにくい構成です。ただし、実機で示されたのは印刷パッチ条件での成功率改善であり、現場の照明変動、遮蔽物、複数物体、動線上の人の出入りまで含めた頑健性は、この情報だけでは判断できません。
日本の現場で考えると
この論文は、受付、案内、ピッキング補助、簡易搬送のように、カメラで周囲を見ながら動くロボットに関係します。日本の現場では、通路幅や人の往来だけでなく、掲示物、反射、ラベル、印刷物などが認識に影響することがあります。印刷パッチへの耐性が改善したという結果は、こうした視覚的な妨害や誤認識リスクを考える入口になります。
一方で、工場や倉庫で本当に重要なのは、単発の成功率だけではありません。連続稼働中にどれだけ介入が必要か、レイアウト変更後に再調整が要るか、既存のWMSやMES、PLCとどうつなぐかが導入可否を左右します。視覚防御が強くなっても、現場の安全ルールや停止条件が曖昧なら運用は安定しません。
導入・PoCで確認したいこと
- 印刷パッチや掲示物がある条件での作業成功率
- 固定攻撃と適応攻撃での性能差
- 連続稼働時の介入回数と復旧時間
- レイアウト変更後の再設定時間
- 既存バックボーン間での効果差
現時点で分かっていないこと
この情報だけでは、SN-TRVがどの程度の計算負荷を増やすのかは確認できません。追加推論モジュールは不要とありますが、実運用でのメモリや更新手順の負担までは不明です。
また、実機試験はPiPERでの結果が示されていますが、日本の製造・物流・サービス現場で同じ改善幅が出るかは分かりません。対象タスク、カメラ条件、現場の照明や物体配置が異なるためです。
視覚認識の誤作動は、現場導入では小さく見えても運用に影響します。PoCで何を測るべきか整理したい場合は、検討の起点としてご相談ください。
ロボット導入・自動化をご検討の方へ
「自社にはどんなロボットが合うのか」お悩みではありませんか。貴社の現場課題に合わせた最適な活用方法をご提案します。まずはご相談・資料請求からお気軽にどうぞ。

