生成AI×ロボット、ChatGPTの登場はなぜロボットを変えたのか
生成AIブームとヒューマノイドブーム、一見別世界の2つが「フィジカルAI」という言葉のもとで急速に融合している。
「生成AIブームとヒューマノイドブームは関係があるのですか?」答えは「大あり」です。
文章や画像を作る生成AIと、体を動かすロボット。一見別世界の2つが今、「フィジカルAI(Physical AI)」という言葉のもとで急速に融合しています。今回はその関係を、できるだけ平易に解説します。
1. LLM、ロボットが「言葉」を理解した
まずLLM(大規模言語モデル)です。ChatGPTに代表される、言葉を理解し生成するAIがロボットに載ると何が起きるのでしょうか。
従来のロボットへの指示は、専門家によるプログラミングでした。それが「テーブルの上を片付けて」という日常の言葉で通じるようになります。しかもLLMは言葉の背後の常識も持っているため、「片付ける=食器はシンクへ、ゴミはゴミ箱へ」という暗黙の前提を補って、作業手順に分解できます。
外国人上司との間に優秀な通訳が入った途端、仕事が円滑になる。あの変化がロボットと人間の間に起きたと考えると分かりやすくなります。
2. VLM、「見て理解する」が加わった
次にVLM(視覚言語モデル)です。画像と言葉を結びつけるAIで、カメラ映像を見て「机の上に赤いマグカップと書類がある」と理解し、「マグカップを取って」という指示と目の前の光景を照合できます。言葉だけの秀才だったLLMが、視力を得た状態といえます。
3. VLA、「見る・理解する・動く」の直結
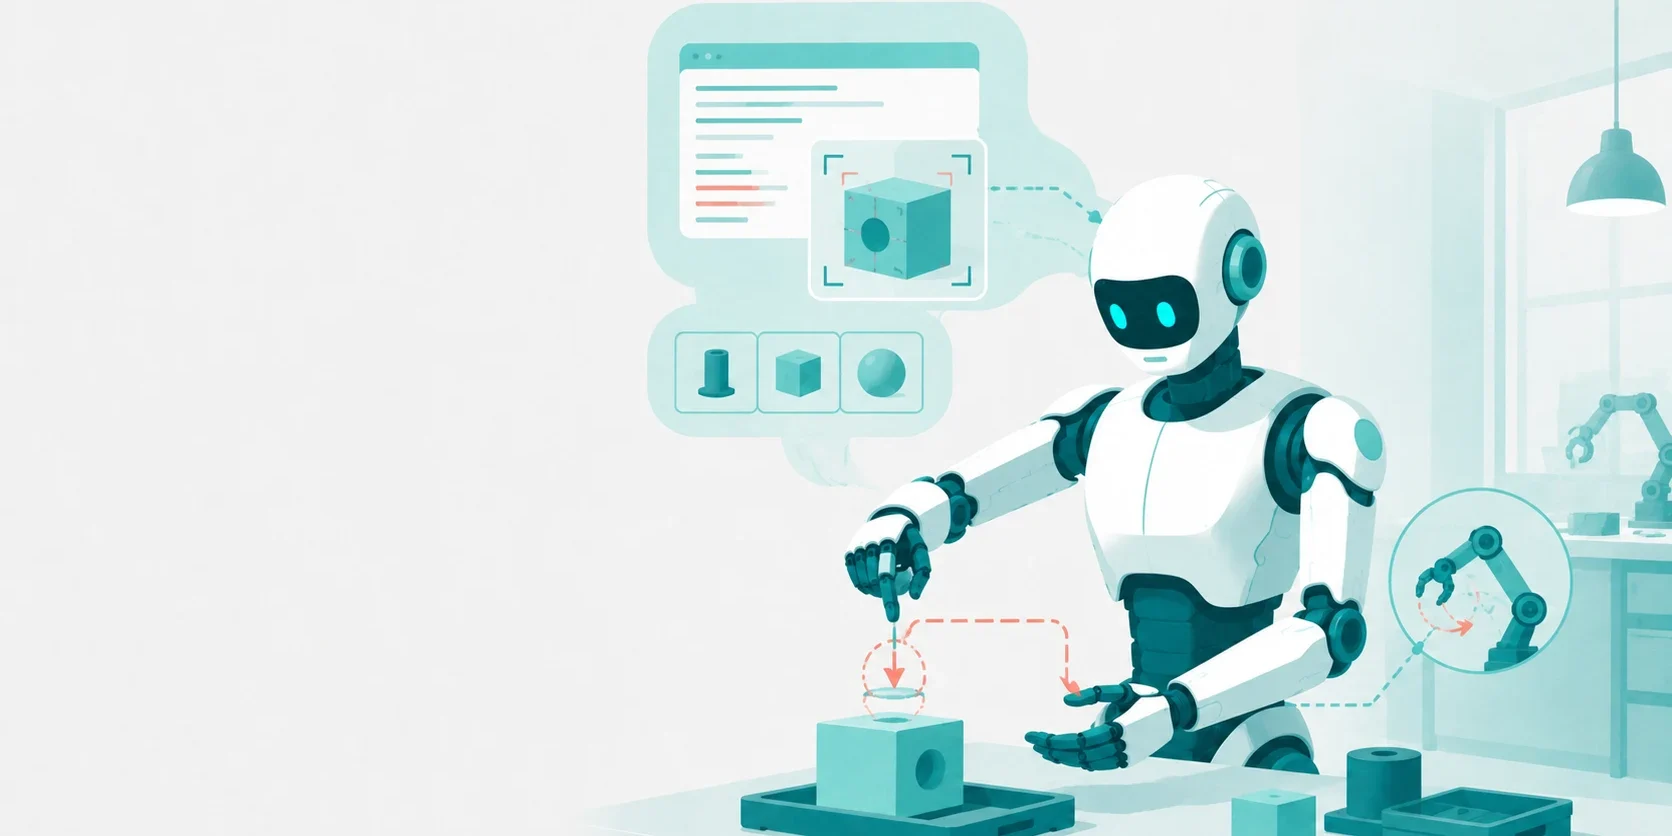
そして本命がVLA(Vision-Language-Action)モデルです。視覚(V)と言語(L)の理解から、ロボットの動作(A)を直接生成します。
従来は「認識→計画→制御」を別々のプログラムが分担し、伝言ゲームのように情報を受け渡していました。VLAはこれを一つのモデルで貫きます。人間にたとえるなら、「見て、考えて、手を動かす」が一連の流れで起こる状態です。伝言ゲームの継ぎ目で失われていた柔軟性が保たれるため、初めて見る物や少し違う状況への応用力が飛躍的に高まりました。
LLM・VLM・VLAの発展の流れ
4. 学習方法との関係、模倣学習・強化学習
VLAのようなモデルは、どう賢くなるのでしょうか。基盤には、生成AIと同じ「大量データからの学習」があります。人間のお手本動作から学ぶ模倣学習、試行錯誤とご褒美で上達する強化学習、そしてシミュレーション空間での大量練習です。生成AIが世界中の文章を読んで言葉を覚えたように、ロボットのAIは大量の「動作データ」を学んで体の動かし方を覚えます。文章の次に、AIが学ぶ対象が「物理世界での行動」になった、これが「フィジカルAI」という言葉の意味です。フィジカルAIの全体像ははじめてのフィジカルAIでも紹介しています。
5. なぜ「今」ヒューマノイドなのか
生成AIの汎用的な頭脳を得たことで、ロボットは「一つの作業専用の機械」から「いろいろな作業を覚えられる存在」に変わりつつあります。汎用の頭脳には汎用の体が要ります。人間の環境でそのまま働ける人型の体と、何でも学べるAIの頭脳、この2つがそろったことが、世界的なヒューマノイド投資の理由です。研究開発の観点でこの技術を実際に試したい方はWalker Tienkung DEXでできる研究開発もご覧ください。
技術の進化と現場実装の間にあるギャップ
VLAモデルの進化は目覚ましいものですが、研究レベルのデモと現場での実運用の間には、一般的に次のような論点が存在します。
- 学習データの偏り
特定の環境・対象物で学習したモデルは、大きく異なる環境ではそのままの性能を発揮しにくいことが知られています - 推論の計算コスト
大規模なVLAモデルをリアルタイムで動かすには相応の計算資源が必要で、エッジで完結させるか外部推論に頼るかの設計判断が伴います - 失敗時の挙動設計
AIが誤った判断をした場合にどう安全に停止・復帰させるかは、モデルの精度とは別に設計しておくべき論点です
よくある質問
Q. VLAモデルは、どのロボットでも使えますか。
機体側の演算基盤や制御インターフェースの開放度によります。低レイヤの制御まで対応した機体でないと、VLAの出力をそのまま動作に反映しにくい場合があります。
Q. 自社の作業データでVLAを学習させることはできますか。
テーマや対象作業によります。テレオペによるデモデータ収集など、学習の土台となる仕組みが整った機体であれば検討の余地があります。詳しくはご相談ください。
Q. フィジカルAIと従来のロボット制御は何が違うのですか。
従来は認識・計画・制御を個別のプログラムで設計していましたが、フィジカルAIは大量データからの学習によってこれらを一体的に扱える点が大きな違いです。
まとめ
生成AIは、ロボットに「言葉がわかる頭脳」と「応用が利く運動能力」の両方をもたらしました。この技術動向を自社の現場にどう取り込むか、GA Roboticsでは、LLM/VLAを活用したデモのご紹介から、研究開発・PoCのご支援まで対応しています。「まず動いているところを見たい」というご要望も歓迎です。